局势大变:AI 应用层开始只关注 feature 上线的速度,不再关注核心迭代的质量和方向。模型在变强,大厂的通用产品在变全,套壳前所未有地容易,「先上线再说」成了默认节奏。
局势大便:在这种节奏下,别人一天能做到 50 分,你花了几个月可能还在 70 到 80 分之间徘徊。行外人看不到那 20 到 30 分的差距,只看到别人快、你慢,于是你的价值被极大地质疑。短期内,劣币占住了良币的位置。
这篇想说的是:对认真做产品的团队来说,大便最痛的一层是可见性问题。 好东西不会因为被低估就变差,但它必须想办法被看见,并且熬到被看见的那一天。
一、劣币从哪来
AI 生产本身不是坏事。用 AI 画画、写歌、写小说,普通人有机会自娱自乐,创作者也能提高效率。
问题出在「有枣没枣打一耙子」的人身上。他们用纯自动化生成的内容批量冲击发行平台,挤占了认真使用 AI 的作品的空间,也挤压了正常作品的生存空间。平台要处理的并不是「作品用了 AI」这一个标签,而是批量上传、重复内容和操纵分发的行为;Spotify 对垃圾内容的说明正好把这个区别讲清楚了。
AI 应用层是同一个故事。表面精美、实际毫无含金量的东西冲击着每一个团队,尤其是团队的老板。垂类团队精心设计的东西,一天就能被扒走八成外观和顺利路径,你还得花大量的决心和口舌去向上下游解释:我们的设计有价值,中期迭代时会拉开差距,别人只是暂时形似。
二、那 30 分到底是什么
50 分和 80 分的产品,在 demo 里几乎看不出区别。区别出现在 demo 之后:
- 长尾可靠性。 即便 95% 的常见请求都对,剩下的长尾仍可能造成线上事故。
- 成本。 跑一次要花多少钱,规模上去之后还撑不撑得住。
- 可调试性。 出了问题能不能定位,还是只能重跑一遍祈祷。
- 合规。 数据去了哪里,谁能审计,边界有没有被绕过。
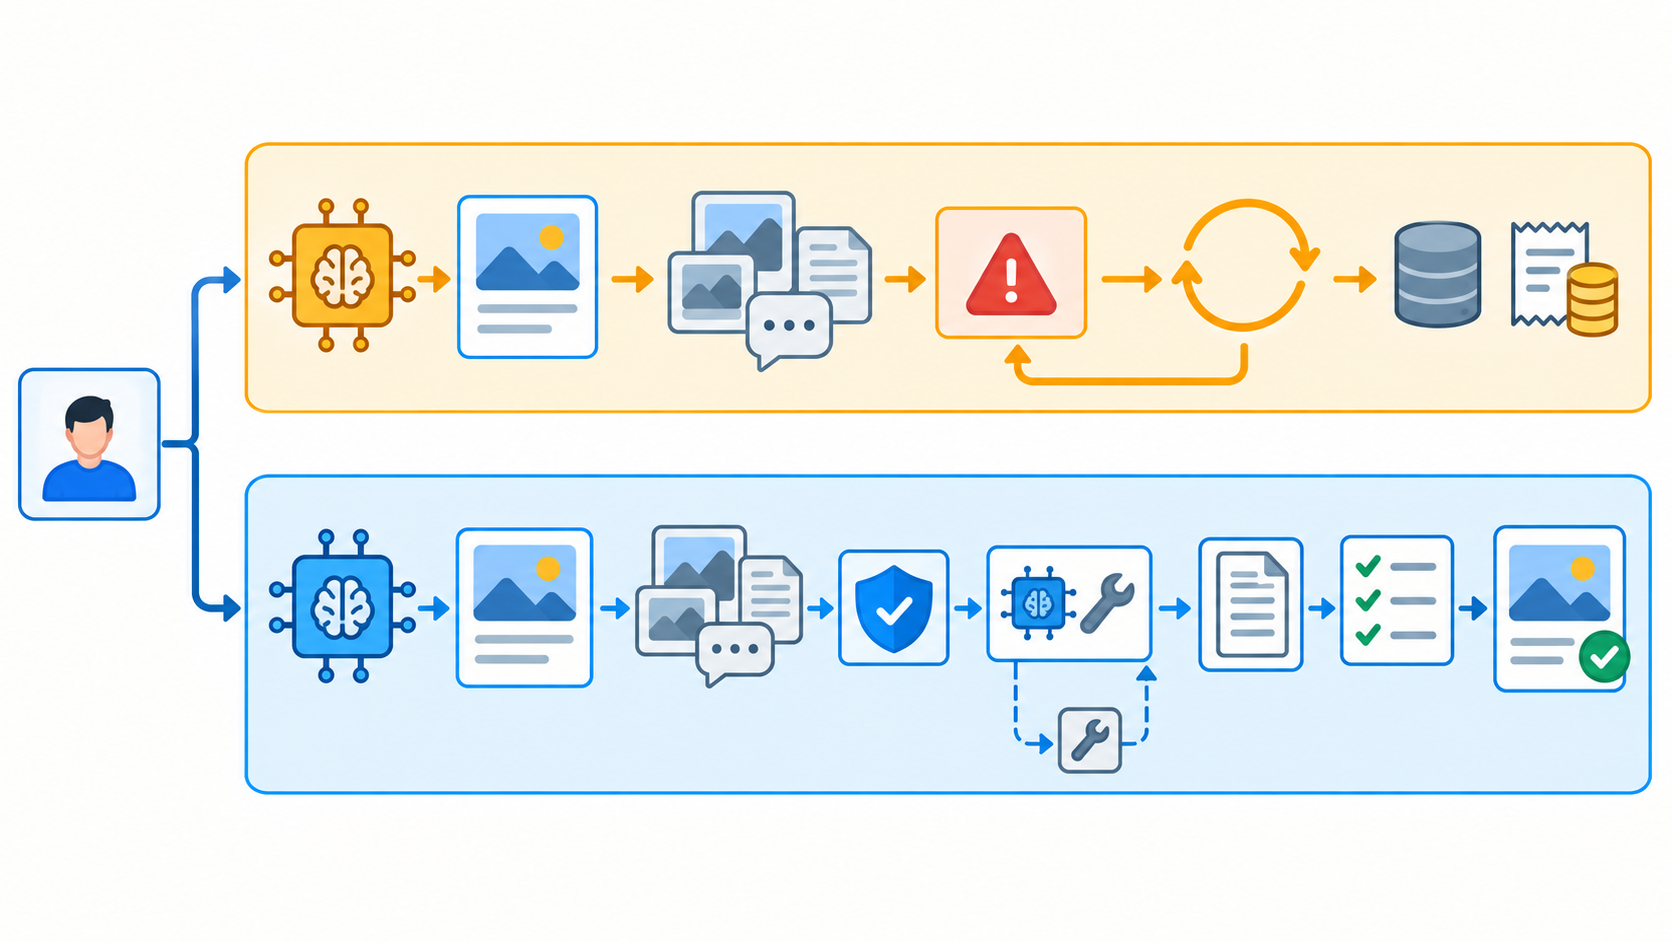
图注:同一个请求的首轮结果可能很像。上排橙色在遇到异常后反复重试,成本与故障难以说清;下排蓝色加入边界校验、故障定位、修复回归和结果检查,差距在长期运行中显现。
回归测试和合规兜底尤其不显眼:它们平时不产生什么可见的东西,只有没做的时候,才会以事故的形式出现。这也是为什么 tracing 和调优,在不少团队里从售前要解决的问题,变成了售后的问题定位和响应。认真做这些的团队显得慢,甚至显得在做无用功。
还有一类人让我印象深刻:产品自己都不用。在 AI 时代,我把他们形容成开餐厅却从不带自己的亲人朋友来吃的老板。不用,就永远不知道那 30 分缺在哪。
三、熬过水下时间
劣币在短期最容易占据可见位置。好产品要熬过水下时间,不断迭代,才有机会用长期表现拉开差距。也得承认,总有做得好却没熬过去的产品,我们只是没怎么听说。
我为什么不觉得 Cursor 是套壳产品?因为在我看来,它明显是被真正写代码的人反复打磨出来的:用起来舒服,UI/UX 在当时是领先的。更重要的是,这类产品有教育意义:经验以产品 UX 的方式传递给了使用者。 好的产品让人变得更专业,产出更多价值。
当然,Cursor 是水平产品,正面承受着 Codex 和 Claude Code 的竞争,处境和垂类不同。我拿它只想说明一件事:是不是套壳,不取决于技术形态,而取决于做的人有没有真的在用、有没有把经验沉淀进产品。 好 UX 也不保证活下来。
「熬」不是干等。至少有两件事可以做:持续交付小而可见的增量,别让团队消失几个月;尽早把看得见的数字摆给老板。这是第五节要讲的。
四、harness 的两极化和黑箱
让 LLM 算加减法,不只是一个笑话。它指的是把本该由确定性代码处理的事——计算、校验、格式转换——也交给模型去做。
新入行的开发者越来越少见到 agent 的基本结构:模型决策、调用工具、拿到结果、再决策的那个循环。这不是「现在的年轻人不行」,而是结构性的:harness 变成黑箱之后,没有人再被迫去看里面。可在短短两年前,这还是做 agent 的基本知识。
Codex 和 Claude Code 把通用编程 agent 的体验门槛抬得很高:要么你做得不如它们,那就直接用它们;要么你就得在垂类里做得更好。我感到中间地带正在变窄。
更进一步,很多生产环境里的大模型边界,本应由合适的机制在严肃场合处理,但实现却越来越往「大力出奇迹」靠拢:垂类功能用 Skill,功能和审核的 fence 用 Skill,LLM as judge 还是用 Skill。
我不是在讨论 Skill 本身的好坏。它确实实用,一个通用的 Bash 工具能装载许多能力,事实上很优雅。不优雅的地方在于,人们不再关注 Skill 是怎么被加载的、中间发生了什么,却把 Skill 的创作和审核全盘交给 agent 自己。
我们在金融领域做 KYC 任务时,就遇到过边界被绕过的问题:agent 输出了不合规的内容,还提供了不属于自己服务范围的服务。
这件事没办法靠 Prompt 完全限制。更麻烦的是,为了堵这个口子去改 Prompt,会连带影响整个 agent 的表现,所以每一次修改,都得把已有的 case 全盘回归一遍,确认没有哪里劣化。越权调用和服务范围,还需要权限、确定性规则和人工复核等机制兜底。
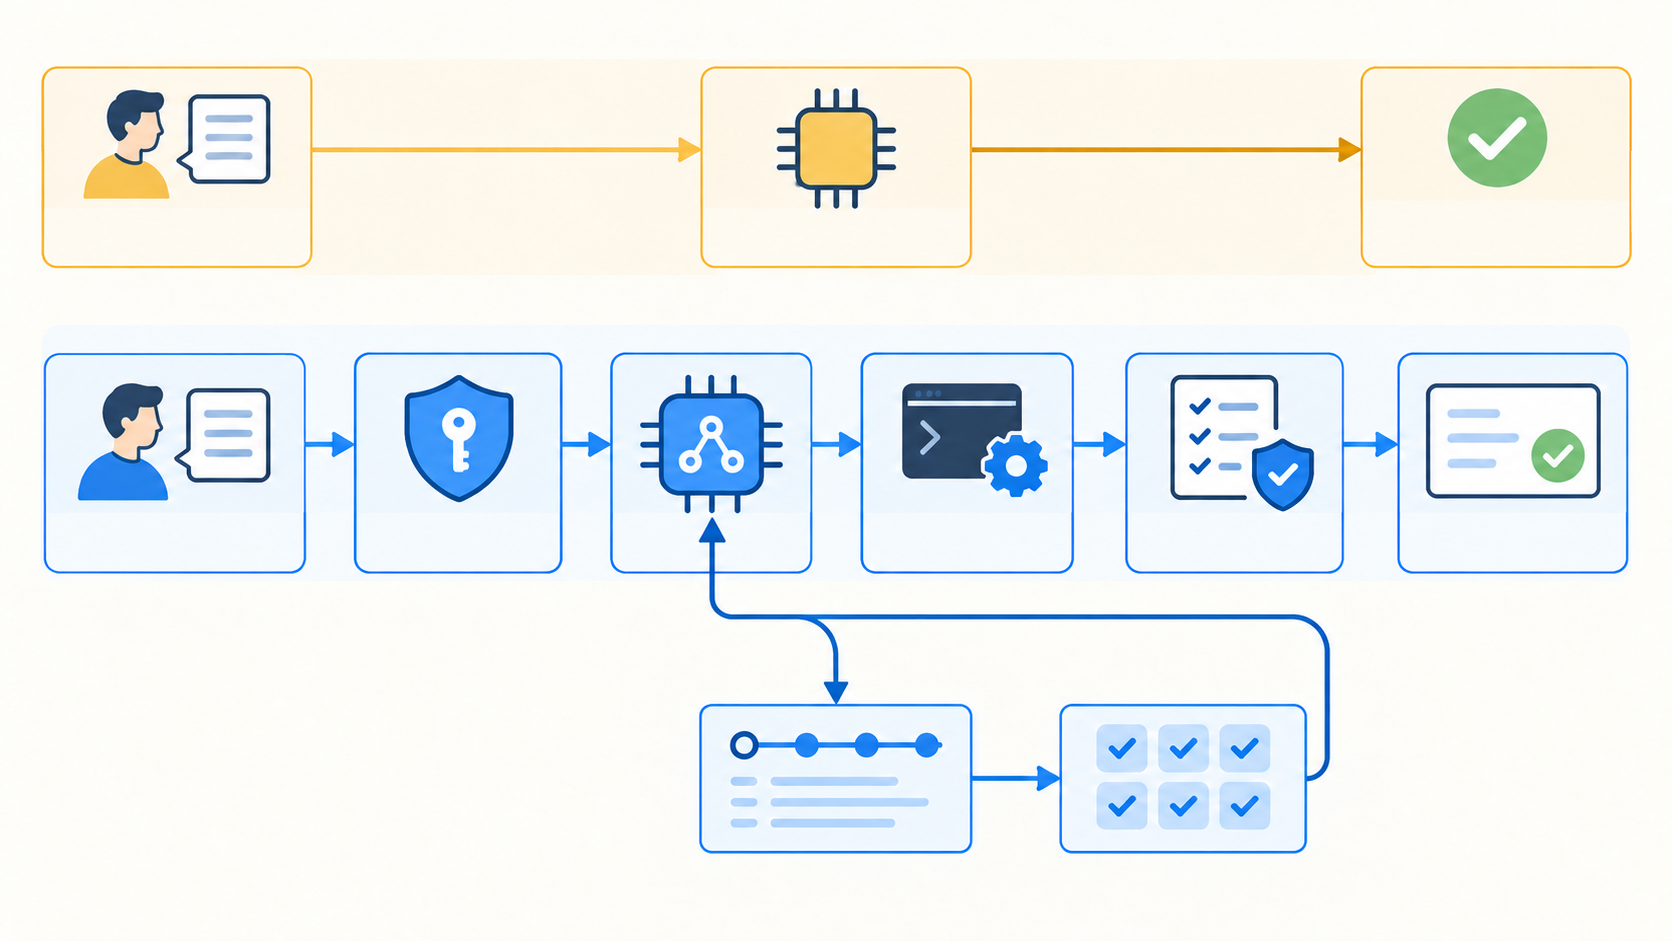
图注:上排(橙色)是演示路径:请求 → 模型 → 结果。下排(蓝色)是生产路径:请求 → 权限与服务范围校验 → Agent 规划 → 工具执行 → 结果校验 → 输出;下方的 trace 记录与回归用例把发现的问题反馈到下一轮调整。越界或不确定的结果还需要拒绝或人工复核。
图里两侧的校验不该只写在 Prompt 里。中间的 trace 留下过程证据,失败样例进入回归集;下一次改 Prompt、换模型、调整 Skill,都要重新跑已有 case。这套「改一处,测全盘」的流程,是做严肃 agent 的基本功。但我渐渐发现,它也越来越少被人提起了。
五、成本与合规:让那 30 分被看见
人们同样不再关注 context 的合理利用,也不再关注 context 怎么加载、何时卸载:反正交给别人的 harness,反正别人的模型还在迭代。似乎模型更聪明之后,harness 就不用精细构建了。
但垂类 App 的创作者需要关心成本,不能只专注于从 0 到 1、从 0 到 feature 实现。把确定性的步骤从模型调用中拆出来,按需装载上下文,往往能省去不必要的推理开销。算个 1+1,用确定性代码几乎没有成本;交给通用 agent,就可能带上上下文装配、模型推理和工具调用。这些差距到底有多大,要拿同一批任务、同一质量门槛来实测。
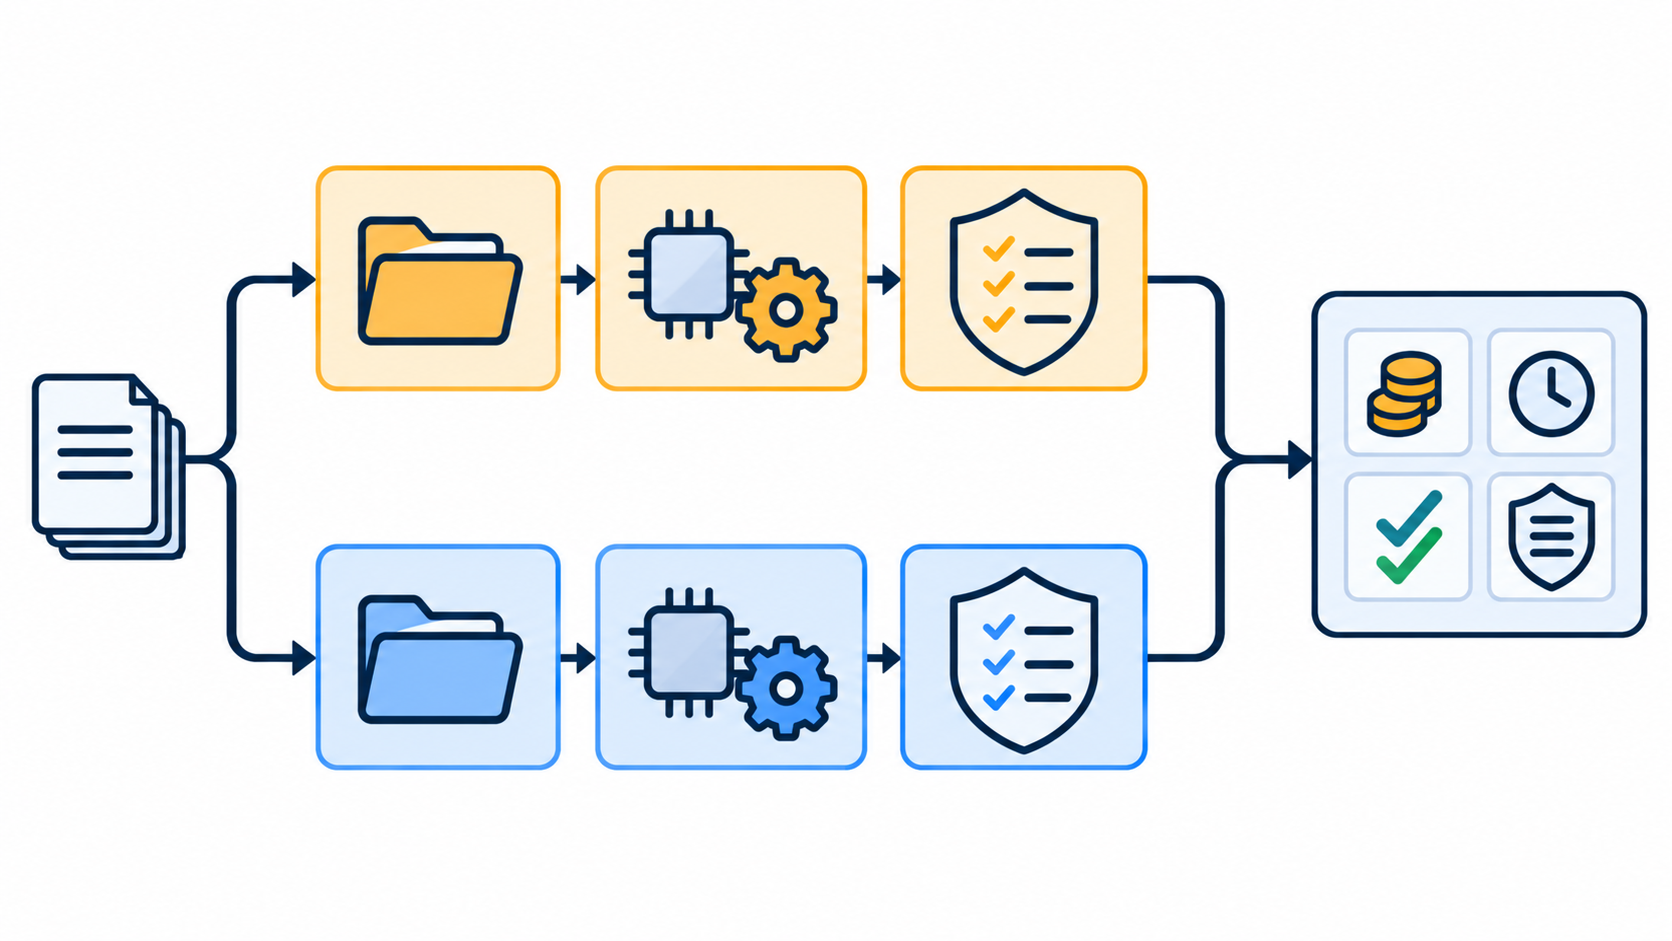
图注:让通用 harness 与定制 harness 处理同一批任务、满足同一质量门槛,再用一张指标表比较单任务成本、延迟、成功率、人工接管率、越界拦截与审计链完整性。图中没有预设哪一方胜出。
成本和合规,是垂类 App 很好的切入点。它们值钱,也容易把那 30 分变成可见的证据。老板不需要懂 agent 拓扑,也能看懂同等质量下的单任务成本、失败率和人工接管比例。
合规尤其如此:它的价值往往只有在边界被绕过时才会显现。垂类团队可以把「没被绕过」变成可复核的东西,比如越界样例的拦截率与误拒率、回归测试覆盖、可追溯的审计记录。一次漂亮的 demo 做不到这些。
这正是对付「局势大便」的办法:你没法让行外人立刻理解你的设计理念,但可以把设计带来的结果,变成他们看得懂的数字。
六、什么会证明我错
我也该说清楚,什么情况会让我改变看法。如果有一天,通用模型加通用 harness,在垂类场景里能以很低的成本稳定做到接近 100% 的可靠,而且数据合规问题也被解决,那么定制 harness 的价值确实会被大幅压缩。
但至少今天,我没有看到模型迭代真的解决了 harness 图拓扑和调优的问题,它只是把问题掩盖了,变成了黑箱。我也不认为 AI 图片替代了优质的摄影师、设计师和画师,不认为 AI 视频替代了导演和演员。
我最喜欢的动漫《灵能百分百》第二季第十集里,肉体改造部与靠超能力强化肌肉的对手交手。那场戏让我想到:日复一日练出来的底子,不能靠能力一键生成;能力至多把已有的积累放大。
结语
机器学习和软件工程里,各有一句我常想起的话:No Free Lunch;No Silver Bullet。前者提醒我们,脱离具体问题,不存在始终占优的方法;后者提醒我们,复杂的工程问题没有单一技术能包办。这几乎是垂类 App 的自我辩护:没有领域深度的套壳没有护城河,「一句话生产 xxx」的演示也只是演示。
平均的输入,一定产生平庸的结果。别人一天做到 50 分,不代表你数月的 80 分没有价值。各位无须怀疑自己的努力,但也别只是埋头:把那 30 分,做成别人看得见的样子。